微信一扫
就有惊喜

投稿&答疑
纠错&侵删
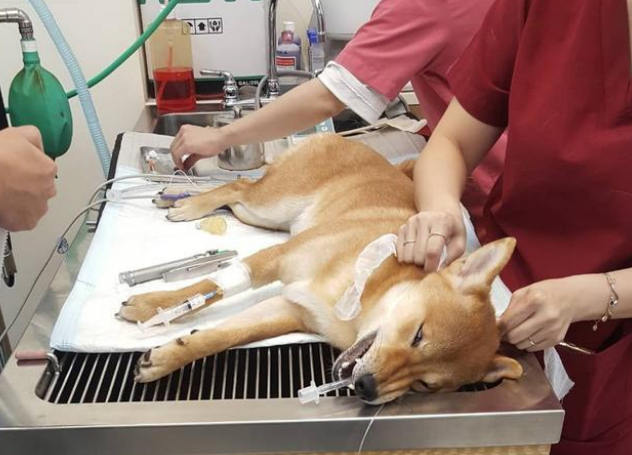
英国兽医协会《兽医记录》刊出的一项研究回顾分析了 225 例匿名犬猫麻醉病例(来自土耳其阿塔图尔克大学兽医院,覆盖 ASA 1 至 5 级),测试三款大语言模型作为麻醉决策支持工具的表现:ChatGPT-4o、ChatGPT-5 与 Gemini 2.5 Pro 在标准化提示下各自判定 ASA 分级并生成麻醉方案;无论 ASA 判定是否一致,全部病例的方案充分性均由两名经验丰富的兽医麻醉专科按四点量表盲评。统计采用 Friedman 检验与 Bonferroni 校正的 Wilcoxon 检验、效应量,并以二次加权 Cohen’s kappa 与组内相关系数衡量评审者信度。结果显示 ChatGPT-5 的 ASA 分级准确率最高(53.3%),其后为 ChatGPT-4o(46.7%)与 Gemini 2.5 Pro(30.7%);模型在 ASA 3-5 的重症病例上表现最好,而 ASA 1(健康)病例常被高估而错分;ChatGPT-5 生成的麻醉方案临床充分性也最高。作者指出单中心、回顾性且仅含犬猫的设计限制了外推,结论是 LLM 能生成有临床相关性的 ASA 分级与麻醉方案,但准确性与偏差方向仍需兽医把关。
背景:大语言模型(LLM)正作为决策支持工具进入人类医学;但它们在兽医麻醉学中的评估仍然有限。
方法:我们回顾性分析了来自阿塔图尔克大学动物医院的 225 例匿名犬猫病例(美国麻醉医师协会 ASA 分级 1 至 5 级)。ChatGPT-4o、ChatGPT-5 与 Gemini 2.5 Pro 在标准化提示下各自独立判定 ASA 分级并生成麻醉方案。无论 ASA 分级是否与人一致,全部病例的方案充分性均由两名经验丰富的兽医麻醉专科医生按四点量表评价。统计分析包括 Friedman 检验与 Bonferroni 校正的 Wilcoxon 检验、效应量,以及评审者间信度(以二次加权 Cohen’s kappa 与组内相关系数评估)。
结果:ChatGPT-5 取得最高的 ASA 分级准确率(53.3%),其后为 ChatGPT-4o(46.7%)与 Gemini 2.5 Pro(30.7%)。模型在 ASA 3 至 5 级病例上表现最强,而 ASA 1 级病例常被错分,主要原因是 ASA 被高估。ChatGPT-5 生成的麻醉方案在临床上最为充分,优于其他模型。
局限性:回顾性、单中心的设计,以及仅纳入犬猫病例,可能限制结果的外推性。
结论:在兽医麻醉学中,大语言模型能够生成具有临床相关性的 ASA 分级与麻醉方案,尽管不同模型表现不一;但专家的把关仍然不可或缺。
网站展示的宠物及品牌信息和数据,是基于互联网大数据及品牌方的公开信息,收集整理客观呈现,仅提供参考使用,不代表网站支持观点;
如有侵权、错误信息,请及时联系我们更正或删除!微信/MOB:189 6200 1606 商务合作加V:15061629188